 無料で相談する→
公開日:2026年9月23日
「GPT-6 Solに替えれば安くなる?」「AstraやClaudeのほうが良いものを作れる?」
モデルが増えるたび、この二つで迷う方は多いはずです。
結論は、GPT-6 SolはGPT-5.6 Solと近い総合評価で、第三者ベンチマークの問題1件あたりのトークン費用は約半分です。
これは実際の業務を完成させる費用が半分になるという意味ではありません。難しい制作物ではAstraやClaudeを選ぶ余地もあります。
本記事は2026年9月23日時点の公式料金と、Artificial Analysisが公開した実測に基づきます。
弊社による有料APIの横並びテストではありません。公開評価の費用と、自分の業務を完成させる費用を混同しないように読み解きます。
前世代からの最大の変化は、API単価が半額になったことです。
OpenAIの標準料金は、入力100万トークンあたり4ドルから2ドルへ、出力は20ドルから10ドルへ下がりました。
トークンはAIが読む・書く量の課金単位です。
GPT-6 Solは、通常の文章生成だけでなく、コードの修正や複数の道具を使う作業を想定したモデルです。
APIでは推論の深さをnoneからmaxまで選べます。
深く考えさせるほど、時間と出力トークンが増える場合もあります。
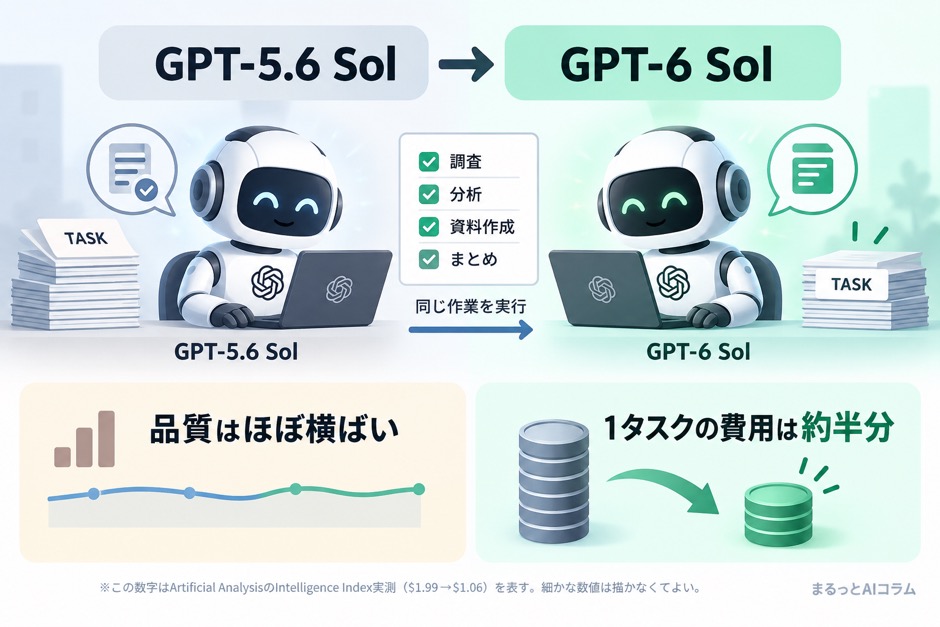
第三者のArtificial Analysisは、複数の評価をまとめたIntelligence Indexで、両モデルのmax設定を同じ物差しに載せています。
点差は小さく、GPT-6 Solは48、GPT-5.6 Solは47です。これを「どんな仕事でも新モデルのほうが上」と読むことはできません。
トークンの単価が安くても、修正を重ねれば実際の業務費用は増えます。
まず、Artificial Analysisが同じ評価群で測った品質とトークン費用を見ます。
同社の「Cost per Task」は評価中の入力・キャッシュ・出力トークンから計算した平均で、人による検品や納品までの再作業は含みません。
| モデル・設定 | 総合スコア | 評価1件の費用 | 読み方 |
|---|---|---|---|
| GPT-6 Sol(max) | 48 | $1.06 | 前世代に近い品質で費用が低い |
| GPT-5.6 Sol(max) | 47 | $1.99 | 同じ評価の前世代 |
| GPT-6 Astra(max) | 53 | $3.26 | 難題で品質を優先する候補 |
| Claude Fable 5.1(max・fallbackあり) | 53 | $7.63 | 高品質だが、この条件では費用も高い |
| Claude Opus 5.5(max・fallbackあり) | 58 | $5.98 | 9月22日発表の新しい比較候補 |
出典:Artificial Analysisの現行リーダーボード、GPT-5.6 Solの評価ページ、費用の算定方法。2026年9月23日確認。総合スコアは同社のIntelligence Index v4.3系です。Claudeの「fallbackあり」は別モデルへ切り替わる設定を含むため、単体モデル同士の純粋な性能差とは言えません。
この表では、Solと5.6 Solの差は1点で、評価1件の費用は約47%低くなりました。一方、AstraはSolより5点高く、評価費用は約3.1倍です。
どのモデルも実際の納品物では手戻りの量が変わるため、ベンチマークの価格比をそのまま自社の費用へ当てはめないでください。
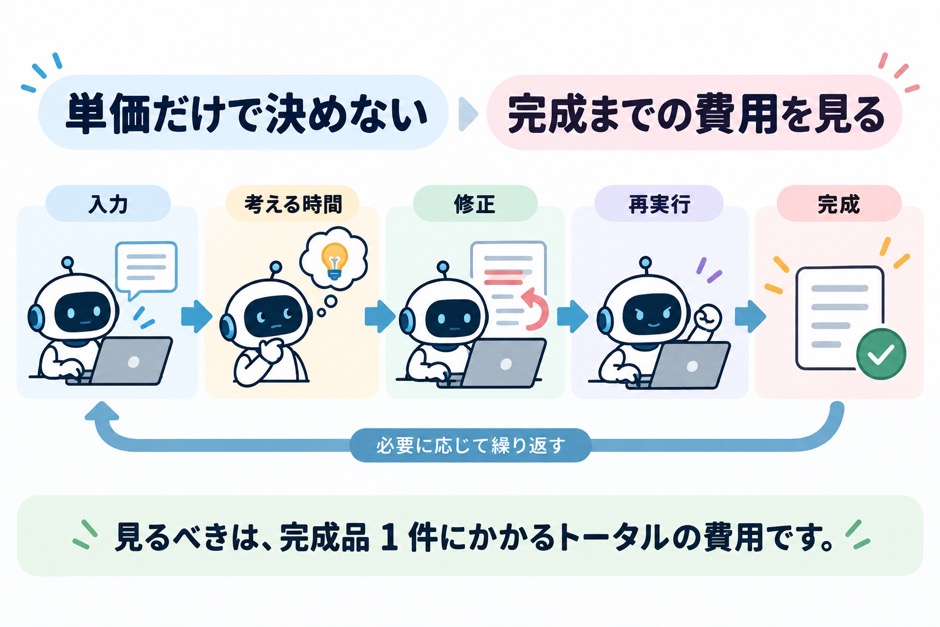
例えば商品説明を1本作るなら、同じ商品情報、同じ指示、同じ合格条件を各モデルに渡します。
最初の文章だけを見ず、事実確認と修正が終わるまでの回数、作業者の確認時間、APIの利用額を残します。
比較するのは「1回の生成費用」ではなく「公開できる説明文を1本作る費用」です。
AIが長い文章を返しても、商品名や仕様の誤りが多ければ安くありません。逆に高いモデルが一度で使える文章を出せば、再生成の費用を省けます。
総合ではほぼ横ばいですが、得意不得意は入れ替わっています。
Artificial Analysisのコーディング評価では、スコアが前世代の55から57に上がりました。
同じ評価での1タスク費用は約半分です。
コードを書く・修正する用途なら、移行を試す理由があります。
反対に、長い資料を読み、条件を守って完成品を作る知識労働の評価では後退が見られました。
評価者は「成果物が短く、求められた項目が抜けやすい」傾向を報告しています。
提案書や調査レポートでは、短い返答を「読みやすい」とだけ評価しないほうが安全です。
事実性にも注意が要ります。同社の知識テストでは、誤った答えを言い切る割合は下がりましたが、答える問題自体も減りました。
「誤答が減った=正答が増えた」ではありません。答えを保留した場合に、担当者が何を調べ直すかまで決めておきましょう。
GPT-6 Solは「全面的に賢くなったモデル」ではなく、前世代級の品質をより低い費用で使いやすくしたモデルです。
出典:Artificial AnalysisのGPT-6 Sol実測。OpenAIの発表記事にもベンチマークがありますが、自社発表と第三者実測は分けて読みます。
Solは「難しい作業を安く試せる中核」、Astraは「さらに難しい仕事の品質を狙う上位モデル」です。
ClaudeにはOpus 5、Fable 5、Fable 5.1があります。9月22日にはOpus 5.5も出ました。
古いモデルだけを比べて「Claudeの現行最良」とは言えません。
| モデル | 標準API入力 | 標準API出力 | 選ぶ前に見る点 |
|---|---|---|---|
| GPT-6 Sol | $2 | $10 | 通常の開発や業務処理を低い単価で試す |
| GPT-5.6 Sol | $4 | $20 | 既存の動作を維持する必要があるか |
| GPT-6 Astra | $10 | $50 | 難題で手戻りが減るか |
| Claude Opus 5 | $5 | $25 | 既存のClaude運用で十分か |
| Claude Fable 5 | $10 | $50 | Fable 5.1へ更新する理由があるか |
| Claude Fable 5.1 | $10 | $50 | 長期の難しい作業で品質差が出るか |
| Claude Opus 5.5 | $4 | $20 | 9月22日登場の新しい選択肢 |
100万トークンあたりの米ドル建て標準料金。出典:OpenAI API料金表、Claude API料金表。2026年9月23日確認。長文入力やキャッシュ利用では別の料金条件があります。
長い資料を一度に渡す人は、Solの「2ドル/10ドル」をそのまま使って見積もらないでください。
OpenAIの仕様では、入力が27.2万トークンを超えると、リクエスト全体に割増料金がかかります。
入力・キャッシュは2倍、出力は1.5倍です。超過分だけへの割増ではありません。
大量のPDFやコードベースを一度に読む仕事では、同じ資料をどう分けて渡すかまで比較対象になります。
繰り返し読む指示や資料をキャッシュできれば、Solの入力単価は100万トークンあたり0.20ドルです。
Fable 5.1のキャッシュ読み取りは0.25ドル。Fable 5の1ドルから下がりました。
ただし、キャッシュが実際に効いた割合を見ずに、常にこの単価とは計算できません。
単価だけなら、SolはOpus 5の40%、AstraやFable 5.1の20%です。ただし、両社で同じ日本語を入れてもトークン数は一致しません。
考えるための出力や再試行も請求に入るため、「20%の単価=仕事が20%の費用で終わる」とは言えません。
Artificial Analysisの同一評価では、Astra maxとFable 5.1 maxは総合53で並びました。
評価1件の費用はAstraが$3.26、Fable 5.1が$7.63です。
ただし、これを全てのClaude Code作業に当てはめることはできません。
道具、推論設定、キャッシュ、fallback条件が違えば結果も変わります。
完成した画像の質は、文章モデルの名前だけでは比べられません。
GPT-5.6 Sol、GPT-6 Sol、Astraは画像を読み、文章を返すモデルです。
画像を作るときは、別の画像生成ツールを呼び出します。
OpenAIのAPIでは、画像生成ツールにGPT Image 2.5 SunburstかFlareを指定できます。
OpenAIの公式説明では、Sunburstは仕上がり重視、Flareは速度重視です。
自社の画像でどちらが得かは、別に試す必要があります。
両モデルの画像トークン単価は同じです。ただし、消費量が違えば1枚の料金も変わります。
Responses APIで使う場合は、指示を考える文章モデルのトークン料金も加わります。
ClaudeのOpus 5やFable 5.1も画像を読めますが、Anthropic公式によると画像そのものは生成できません。
Claude Codeで画像ができた場合は、接続した外部ツールとその画像モデルを確認します。
| 比べたいこと | 揃える条件 | 分かること |
|---|---|---|
| 画像モデルそのものの差 | 同じ指示・サイズ・品質設定で、SunburstとFlareを使う | 仕上がり、修正のしやすさ、時間と費用の差 |
| 5.6 Sol・6 Sol・Astraの指示の差 | 元の指示・素材・画像モデル・設定を揃える | 画像への指示や修正の進め方の差。画像モデルの差ではない |
| CodexとClaude Codeの差 | 同じ外部画像モデルと設定を使う | 指示作成と検品を含む作業全体の差 |
Responses APIでは、主モデルが画像用の指示を書き換える場合があります。
実際に画像モデルへ渡った文はrevised_promptに残ります。元の指示と一緒に記録してください。
例えば、記事のアイキャッチなら、次の短い指示をそのまま使います。
横長のコラム用アイキャッチを1枚作成してください。
見出しは「現場写真から報告書を作る」。日本語を正確に表示してください。
左に現場写真を確認する担当者、右に完成した報告書を配置してください。
実在の企業ロゴ、根拠のない数値、余計な英語は入れないでください。
SunburstとFlareを横1536×縦864、画質設定highで各3枚ずつ試します。
日本語の誤字、指定した左右の配置、不要な文字、修正後の崩れを見てください。
1枚だけでは偶然の出来に左右されます。
採用できた画像1枚あたりの生成回数・作業時間・トークン使用量・利用額まで記録してください。
OpenAIの公式ガイドにはSunburstとFlareの同一指示例があります。ただし提供元の例であり、弊社の比較試験ではありません。
仕様の出典:GPT-5.6 Sol、GPT-6 Sol、GPT-6 Astra、OpenAIの画像生成、Claudeの画像機能。2026年9月23日確認。
最初はSolで普段の仕事を1件終わらせ、合格しなかった部分だけ上位モデルと比べるのが現実的です。
最上位モデルを全件に使う必要はありません。一方で、重要な判断を単価だけで安いモデルへ移すのも危険です。
| 困っていること | 原因として確かめる点 | 次の打ち手 |
|---|---|---|
| 5.6 Solの利用費が重い | 同じ作業で出力と修正回数が変わるか | 6 Solで同じ入力を試し、完成費用を比較する |
| Solの提案書が薄い | 必須項目が抜けていないか | 合格条件を明記し、AstraやOpus 5.5でも比べる |
| Claude Codeの作業が高い | 長い会話と再実行が費用を増やしていないか | 同じ課題をCodex側で試し、完成までの作業量を比べる |
| どのモデルも間違える | 根拠資料や確認担当が足りているか | モデル変更の前に、参照資料と人の確認を整える |
この表は「どのモデルが必ず勝つか」ではなく、試験の順番を示します。
営業資料なら事実と表現、コードならテストと動作、調査なら出典と抜けを合格条件にします。
開発ツールの違いはClaude Code・Cursor・Codexの比較記事で整理しています。
1件だけの好結果に引っ張られないよう、簡単・普通・難しい仕事を分けて記録してください。
社内への導入順序が決まっていない場合は、AI導入の進め方から対象業務を選ぶと、モデル比較の前提が揃います。
Excelなら、1行を「同じ入力を1モデルで最後まで処理した試行」にします。
列は「仕事の名前」「モデルと設定」「合格したか」「修正回数」「人の確認時間」「API利用額」「不合格の理由」で足ります。
モデル名だけの感想より、どこで手戻りが生じたかが残ります。
機密情報をそのまま外部サービスへ渡さないことも大切です。
帳票や顧客情報を使うなら、契約条件と社内ルールを確認し、匿名化した少量のデータから始めます。
成果物の最終確認は人が行う前提で比較します。
比較するモデル以外の条件を揃えないと、良し悪しは判断できません。
同じ質問文だけを投げても、渡す資料、使える道具、考える深さ、会話の履歴が違えば別の試験になります。
公開ベンチマークを参考にした後、自分の業務では次のように小さく試してください。
一例として、「商品の仕様書と過去の営業メールから、新商品の案内文を作る」仕事を考えます。
対象商品は架空のものにし、仕様書を全モデルへ同じ順番で渡します。
会話履歴を引き継がず、新しい会話でそれぞれ試します。
合格条件は、モデルの出力を見る前に決めます。
たとえば、仕様にない機能を書かないこと、指定した読者に伝わること、冒頭で用途が分かること、担当者が直す箇所を数えられることです。
採点者が答えを見てから基準を足すと、好きなモデルへ評価が傾きます。
この条件なら、最初の文章だけでなく、担当者の修正を終えて送信可能になった時点を「完了」にできます。
仕様にない機能を一つでも書いたら、文章が流暢でも不合格です。
AIが回答を保留したら、担当者が仕様書を再確認する時間も記録します。
入力文は長い工夫を凝らす必要はありません。仕事に必要な材料と、捏造してはいけない条件を明示します。
以下は比較用の書き方の例です。商品名・仕様・読者は、実際の試験では全モデルに同じものを入れます。
次の仕様書を根拠に、新商品の案内メールを作ってください。
読者は既存顧客の購買担当者です。

条件:
・冒頭2文で、商品が何に使えるかを伝える
・仕様書にない性能、価格、納期は書かない
・確認できない情報は推測せず「要確認」と書く
・件名を1つ、本文を1つ出す

仕様書:
[ここに同じ架空の仕様書を貼る]
同じ指示で2〜3回試すと、たまたま良い出力を引いたモデルを選ぶ危険が減ります。ただし試行回数が増えるほど費用も増えます。
まずは少数の仕事で傾向を見て、差が小さければ別の業務でも確認します。
完成した件数だけでなく、修正理由も残します。
「事実の誤り」「指定項目の抜け」「読みづらさ」「不要な長文」では、対処が違うからです。
事実の誤りが多ければ根拠資料の渡し方も疑います。読みづらさだけなら、指示や編集工程で補えるかもしれません。
比較表の費用は、APIの利用額に再試行分を足し、人の確認時間を別列で見ます。
人件費を無理にドルへ換算せず、どのモデルで何分確認したかを見ます。
上位モデルへ切り替えるのは、修正が本当に減ると確認できたときです。
2026年9月23日時点では、対象の有料ユーザーはChatGPT WorkとCodexでGPT-6 Solを利用できます。
OpenAIはPlus、Pro、Business、Enterprise、Eduを対象に挙げています。通常のChatでは未提供と説明し、画面への反映は段階的です。
無料・Goプランのデスクトップアプリで案内されているのはGPT-6 Lunaです。
APIではgpt-6-solと指定できますが、無料Tierは対象外です。
従量料金が発生するため、試す前に利用上限を設けてください。
ChatGPTの画面で選ぶ場合と、APIからモデルを固定して呼ぶ場合は同じではありません。
画面側はプラン、提供時期、利用量の制限を受けます。
比較テストでモデルを固定したいなら、APIのモデル名と設定を記録します。
出典:OpenAIの提供案内、GPT-6 SolのAPI仕様。
公開データから言えるのは、Solの単価と評価タスク費用が下がり、総合品質は前世代と近いことまでです。
業種ごとの最良モデルや、弊社の業務での時間短縮率を示す実測はありません。
この記事の価格・評価値を、あなたの会社の請求額や成果保証に読み替えないでください。
今回、有料APIを使う独自の横並び試験は実施していません。
画像についても、SunburstとFlareの実画像を同条件で生成した試験は未実施です。
Claude CodeとCodexは、モデル以外に道具、システム指示、確認の仕組みも異なります。
完成品だけを並べても、モデルの純粋な能力差とは断定できません。
まずは今週の仕事から、検品方法が決まっている1件を選んでください。
Solで完成までやり、抜けや修正の多かった部分だけAstraかClaudeで試す。それで初めて、あなたの仕事で払う価値のある差が見えます。
よくある質問
Q. GPT-6 SolはGPT-5.6 Solより賢いですか?
A. 第三者の総合評価では大差はありません。Artificial Analysisの同一版ではmax設定で48対47ですが、作業によって改善と後退の両方があります。前世代からの主な利点は、APIの標準単価と評価タスク費用が下がったことです。
Q. GPT-6 SolとGPT-6 Astraはどちらを選ぶべきですか?
A. 通常の開発や調査を繰り返すなら、まずSolで完成品質を確認すると費用を抑えやすくなります。難しい設計や重要な判断でSolの修正が増える場合は、同じ仕事をAstraでも試し、完成までの費用と手戻りを比べてください。
Q. Claude Opus 5やFable 5.1よりGPT-6 Solのほうが得ですか?
A. APIの標準トークン単価ではSolが安いですが、品質まで含めた結論は仕事によります。9月22日にはOpus 5.5も発表されました。古いモデル名だけで比べず、同じ仕事を完成させる費用と修正量を確認してください。
Q. 同じ指示で画像を作ると、5.6 Sol・6 Sol・Astra・Claudeに差はありますか?
A. これらは画像を直接描くモデルではないため、モデル名だけで完成画像の質は比較できません。OpenAIでは画像生成ツール側のモデルも指定します。Claudeは画像を読み取れますが、画像自体は生成できません。画像の出来を比べるなら、使った画像モデルと、実際に画像モデルへ渡った指示を記録してください。
Q. ChatGPTの普通のチャットでGPT-6 Solを使えますか?
A. 2026年9月23日時点のOpenAI発表では、対象の有料ユーザーはChatGPT WorkとCodexから利用できます。通常のChatではまだ提供されていないと案内されています。画面に見えない場合は段階的な提供を待つ必要があります。
Q. 無料プランでGPT-6 Solを使えますか?
A. OpenAIの発表では、無料・Goユーザーがデスクトップアプリで使えるのはGPT-6 Lunaです。同じ発表で、GPT-6 SolはPlus、Pro、Business、Enterprise、Edu向けと案内されています。APIの無料TierでもGPT-6 Solは対象外です。
Q. この記事には独自の横並びテストがありますか?
A. ありません。有料APIを使った同一条件の比較は実施しておらず、モデル提供者の公式資料とArtificial Analysisの公開された実測を分けて掲載しています。社内業務に導入する際は、自分たちの実データを匿名化し、同じ入力と合格基準で小さく比較してください。
まるっとAI編集部
業務のヒアリングから、生成AIを使った専用ツールの設計・開発・改善まで支援しています。既存のExcelや業務ツールを確認し、AIの下書き、人の確認、通常の自動処理を分けながら運用できる仕組みを設計します。