「Opus 5.5でゲームを作った」。Xには目を引く投稿が並びます。
ただ、動画がきれいなことと、自分の仕事でも正確に使えることは別です。
この記事ではXの元投稿6件を確認し、実際に示されたこと/まだ分からないことを分けます。
料金と性能についてはAnthropicの公式発表を確認しました。
編集部によるOpus 5.5のAPI実行テストではありません。
投稿者の自己申告や提供元の試験結果は、その出所を明記して扱います。
この記事は、Xで新モデルの作品を見て「自分の会社でも使えるのか」と考えた人に向けています。
Web制作、資料の確認、コード改修では、合格の条件が違います。
どの投稿が自分の仕事に近いかを見つけ、次に試す一つの作業を決めてください。
料金や提供条件は変わるため、判断前に公式情報も確認してください。
この記事で分かること
- 今回のX投稿だけで、Opus 5.5の画像生成能力は評価できません
- 派手な作品を再現するより、今の仕事で毎回発生する一つの課題を選びます
- Xの成功例を、導入の証拠ではなく「試してみたい課題を見つける材料」として使うのがよいと考えます
まず結論:コードで
作る仕事の幅が広い
Web表現をコードで作る例が複数あります。
コード移行の時間・費用や、企業内の資料処理での使用量が減ったという報告もあります。
一方、完成した画面だけで再現性や正確さは判断できません。
画像素材を別のAIが作った例もあります。
ここで比較できるのは、投稿者が明示した条件と結果だけです。
制作動画と業務の成績を一つの「すごさ」にまとめると、導入判断を誤ります。
この記事の読み方
投稿を見たら、何をOpusが担当したか確かめてください。
その後、自分の課題で小さく試します。
| 投稿で見えるもの | そこから言えること | まだ言えないこと |
|---|
| Webの動画・ゲーム | 特定の指示で動く作品を作れた | 画像もすべてOpus製、毎回同じ品質とは限らない |
| 大規模コード改修 | 投稿者の条件下でテストを通した | 自社のコードでも安全に動くとは限らない |
| 企業の試用報告 | その組織の対象業務で改善があった | 別の会社の費用や品質まで保証しない |
Xの実例6件を、
元投稿から読む
投稿者の発言を短く整理しました。
数値がある場合は投稿者の報告であり、編集部の実測ではありません。
1. 自転車に乗るペリカンを
Three.jsで表現
Addy Osmani氏は、自転車に乗るペリカンをThree.jsで表現しました。
見えているのは、立体表現をWebのコードとして組み上げる力です。
ただし投稿本文だけでは、最初の指示、修正回数、制作時間は分かりません。
仕事なら、商品の展示ページや立体的なデータ表示が近い用途です。
見るべきなのは、動画の美しさだけではありません。
スマートフォンでの動作や読み込み時間も確かめます。
投稿だけでは、その点まで合格したとは分かりません。
元投稿:Addy Osmani氏のX投稿
2. 画像モデルを使わず、
プログラムで絵を描く
Jake Eaton氏は、さまざまな画風の作品を紹介しています。
画像モデルではなく、生成したPythonのプログラムでピクセルを描いたと説明しました。
「絵を直接生成した」のではなく、「絵を描くプログラムを書いた」例です。
投稿では約7,500行のコードに言及していますが、編集部はそのコードを実行していません。
同じ方法を業務で使うなら、商品画像のように厳密な色・形が必要な用途には慎重です。
プログラムが描いた絵は、画像モデルの出力とは修正方法も違います。
例えば、色や位置を一定の規則で再現したい図ならコードが役立つ可能性があります。
一方で人物写真やブランドの製品写真を、この投稿から任せられるとは言えません。
元投稿:Jake Eaton氏のX投稿
3. ゲームのコードはOpus、
絵の素材は別モデル
ゲーム投稿では、投稿者はコードにOpus 5.5、素材制作にGPT-6 Solを使ったと説明しています。
ただし、実際の画像生成モデルや接続したツールは本記事では確認できていません。
見た目の良さを、すべてOpusの画像生成能力と受け取るのは誤りです。
コードと絵の素材が別々に作られた例として読むと、何を任せるかが見えます。
制作では、コードを書く担当、画像素材を作る担当、動作を確認する担当を分けられます。
複数のAIを組み合わせた成果を、一つのモデルだけの能力として紹介しないことが大切です。
発注や社内共有でも、素材の出どころを確認します。
人が直した箇所も含め、制作過程を聞いてください。
元投稿:sirou氏のX投稿
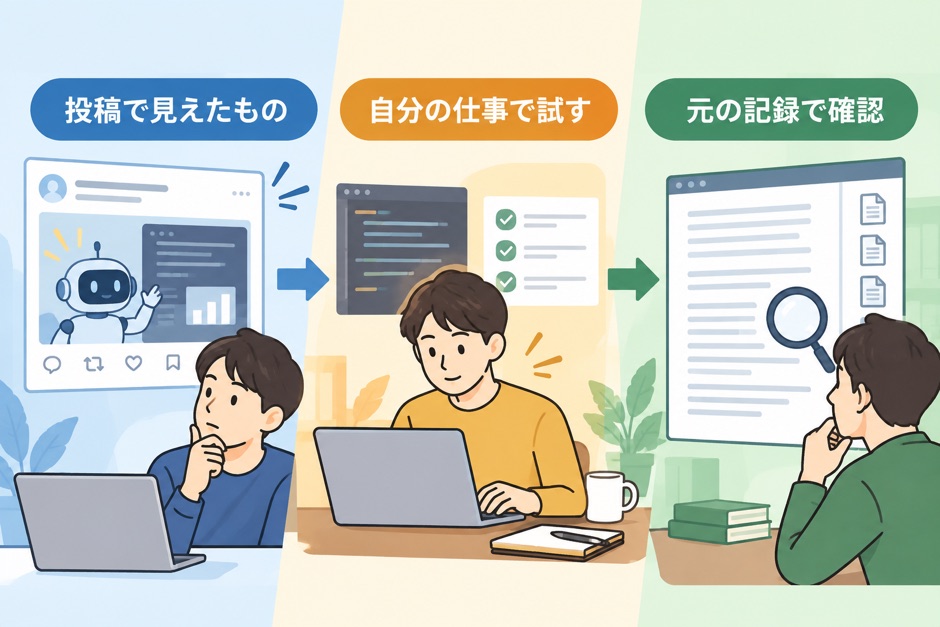 動画の印象だけで導入を決めず、仕事の条件で確かめます。
4. HAProxyの書き換えで
時間と費用の差を報告
AnthropicのBoris Cherny氏は、HAProxyの移行試験を投稿しました。
C言語からRustへ移す課題です。
Opus 5.5とFable 5.1に、同じ課題を与えています。
両者ともほぼすべてのテストを通過したとのことです。
所要時間はOpus 5.5が9.5時間、Fable 5.1が12時間でした。
費用は51%低かったとのことです。
長い仕事の効率を示す例ですが、提供元の内部試験です。
自社でも同じ差が出る保証はありません。
自社のコード改修では、時間だけでなく、既存のテストが通るかを見ます。
修正によって、別の機能が壊れていないかも確認します。
HAProxyのような大きなソフトウェアは、動く状態まで持っていくこと自体が難しい仕事です。
しかし「ほぼすべてのテスト」という表現は、残った失敗が無害という意味ではありません。
元投稿:Boris Cherny氏のX投稿/Anthropic公式発表
5. Boxは企業内の
資料を使う仕事で試用
BoxのAaron Levie氏は、企業内の資料でOpus 5.5を試したと投稿しました。
利用したのは、Box Agentという仕組みです。
Opus 5より使用トークンが63%少なかったという報告です。
ただし投稿からは、対象業務の全内容や測定条件までは確認できません。
「資料が多い仕事なら必ず63%安い」とは読めません。
費用を判断するには、自分の資料で同じ仕事をさせ、実際の利用量と確認時間を測る必要があります。
Box AgentはBoxの資料にアクセスする仕組みの中で使われています。
会社ごとに資料の置き方や権限が違えば、同じ質問でも必要な読み取り量が変わります。
自社では、元資料と答えを照らせる仕事から始めます。
例えば一つの契約書から更新日を探せば、誤答や取りこぼしに気づけます。
元投稿:Aaron Levie氏のX投稿
6. 使いやすさへの
留保も同時に出ている
研究者のEthan Mollick氏は、Opus 5.5の初期試用を高く評価しています。
一方、Claudeの文章が密で読みにくい点は、まだ完全には解消していないと指摘しました。
同氏は描画表現の例も示しています。
能力が上がっても、読み手に伝わる文章になるかは別の評価です。
文章が読みづらいなら、読む人と用途を伝えて書き直させます。
それでも見出しや要点を人が直すなら、その時間を評価に含めます。
試用者の感想だけで、日本語の読みやすさは決められません。
自分が実際に出す文書で読む人に確かめる必要があります。
元投稿:Ethan Mollick氏のX投稿
画像生成が上手くなった、
と言ってよい?
今回のX投稿だけで、Opus 5.5の画像生成能力は評価できません。
Jake Eaton氏の例は、プログラムがピクセルを描いています。
ゲームの例では、投稿者が素材制作にGPT-6 Solを使ったと説明しています。
Sol自身が画像を出力したという意味ではありません。
Three.jsの動画も、コードで画面を描く仕事です。
コードを通じて視覚表現を作る力と、画像モデルへ同じ文章を渡したときの画質は、別の比較です。
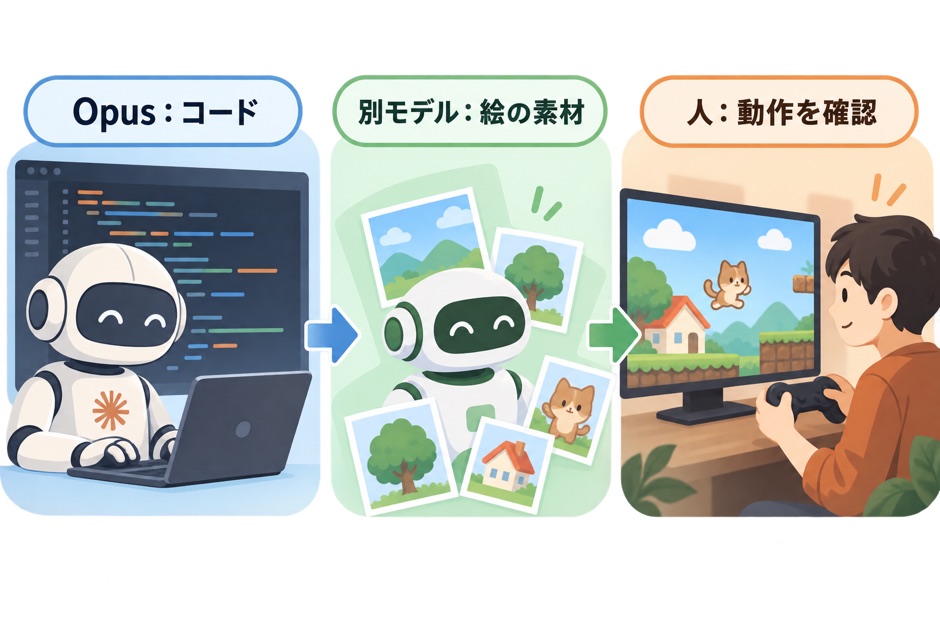 ゲーム投稿では、コードと絵の素材を別のモデルが担当しています。
Web画面のスクリーンショットも、見た目だけでは制作経路を特定できません。
コードを生成したモデルと、画像素材を作ったモデルを確かめてから比較します。
画像生成モデルは、指示文、サイズ、試行回数をそろえて比べます。
Xの完成品だけを並べても条件が違います。
画像生成とコード生成を混ぜずに比べる考え方は、GPT-6 Solの比較記事にもつながります。
料金は安くなった?
APIの公表額を確認
Opus 5.5の標準API料金は入力100万トークンあたり4ドルです。
出力は100万トークンあたり20ドルです。
Opus 5の5ドル/25ドルから、それぞれ20%下がりました。
| API料金(100万トークンあたり) | Opus 5.5 | Opus 5 |
|---|
| 入力 | 4ドル | 5ドル |
| 出力 | 20ドル | 25ドル |
| キャッシュ読み込み | 0.20ドル | 0.50ドル |
Anthropicは、標準設定での典型的な仕事では総費用が約40%下がると説明しています。
これは提供元の試験結果で、すべての仕事にそのまま当てはまる値ではありません。
Claudeの月額料金とAPIの従量料金は分けて確認します。
利用形態を決めずに「1件あたりいくら」と計算するのは避けてください。
同じ仕事を比べるなら、入力・出力トークンだけでなく、やり直し回数と人が確認した時間も記録します。
安く出力できても、手直しが増えれば業務全体は安くなりません。
「単価20%減」と「仕事の
費用40%減」は違う
入力・出力の単価がそれぞれ20%下がっても、実際の費用は使ったトークン数で変わります。
40%という値は、Anthropicが典型的な仕事を標準設定で試したときの総費用の説明です。
少ない手順で終わる仕事では、単価の差以上に総費用が下がる可能性があります。
一方、長い文章を何度も出し直す仕事なら、その差は小さくなるかもしれません。
キャッシュ読み込みの単価も下がっていますが、実際にキャッシュを使えるかは呼び出し方次第です。
表の0.20ドルだけを見て、すべての入力がその価格になると考えないでください。
ベンチマークの
順位だけで選ばない
Anthropicの表で、Opus 5.5は66.4%でした。
対象はTerminal-Bench 4.0です。
同じ表のFable 5.1は55.8%でした。
しかしこれは、対象の課題、思考量、実行環境が決まった試験です。
同社自身も、上位モデル間の点数差は実際の仕事の差を予測しにくくなったと説明しています。
例えば見積書の確認に強いかは、この端末操作の点数だけでは分かりません。
モデル比較では「誰が測ったか」「何の仕事で測ったか」「同じ条件か」を先に見ます。
Xの投稿、提供元の試験、自分の仕事での実測は、証拠の種類が違います。
出典:Anthropic「Claude Opus 5.5」公式発表(2026年9月22日)。
料金は2026年9月29日に確認しました。
仕事で試すなら、
何を比べればよい?
派手な作品を再現するより、今の仕事で毎回発生する一つの課題を選びます。
例えば、会議メモから決定事項を抜く仕事を選べます。
見積の条件差を探す仕事や、表から報告文を作る仕事も候補です。
機密情報を入力してよいか、社内規程を先に確認してください。
例:契約更新日の確認を試す場合
契約更新日を探す仕事なら、短い架空契約書を用意します。
会社名などは架空のものに置き換えます。
更新日、解約通知の期限、自動更新の条件を明記したものです。
AIには更新日だけでなく、根拠の文も示すよう頼みます。
解約通知の期限は別に出させます。
日付が本文と別紙で食い違うなら、勝手に一つへ決めずに相違を報告させます。
人は、出力された日付と根拠の文を元資料で照らします。
ここで一つでも期限を取り違えたら、実契約を自動で処理する段階には進めません。
正しく答えた場合も、判断の根拠になった文を残します。
担当者が変わっても、答えを検証できるようにします。
この例は試し方の提案です。Opus 5.5で実行した結果ではありません。
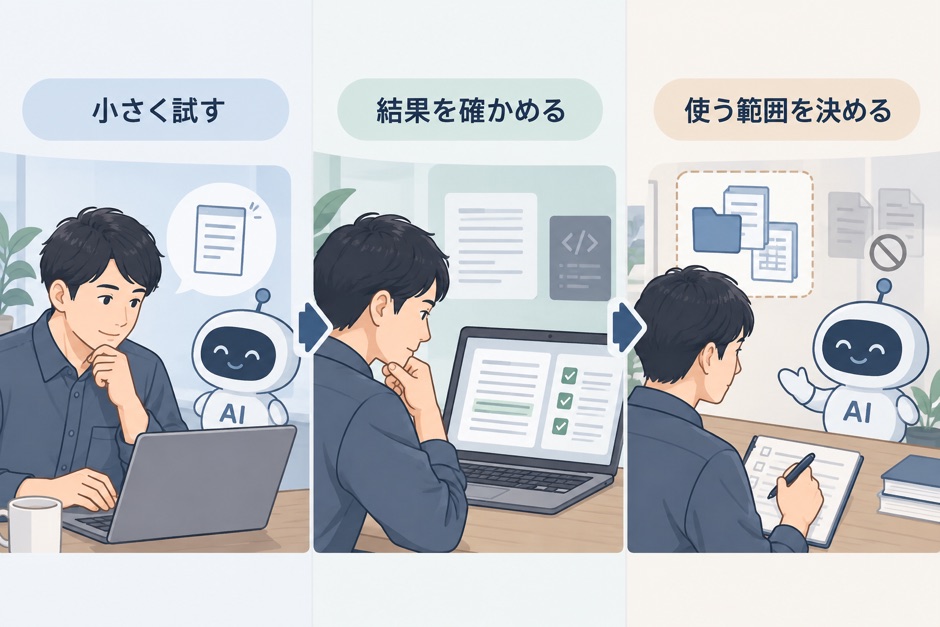 最初から自動化せず、実際の資料と確認手順に合うかを見ます。
| 見る点 | 確かめ方 |
|---|
| 正確さ | 答えの一文ずつを元の資料と照らす |
| 抜け | 人が確認すべき項目を、見落としていないか調べる |
| 手間 | 指示の準備、出力の修正、確認にかかった時間を足す |
| 費用 | 同じ課題で使った量と、再試行の回数を見る |
比較相手は、現在の方法で十分です。
モデルの順位より、自分の仕事で結果が良くなり、確認できるかを優先します。
うまくいった一件だけで
採用を決めない
同じ種類の資料でも、書き方が異なれば結果は変わります。
更新日が一か所だけの契約書、別紙を参照する契約書、更新条件が未確定の契約書を分けて試します。
正解が分からない資料を最初から渡すと、AIの回答を採点できません。
先に人が根拠を確認できる少数の例を選び、どこで間違えたかを記録します。
未確定のものに「不明」と答えるなら、無理に答えを作るより安全です。
仕事で役立つのは、どんな質問にも答えることではなく、判断できないときに止まれることです。
その後、担当者が確認にかかる時間まで含めて比べます。
AIが早く答えても、根拠探しに時間がかかれば、現在の方法より楽とは言えません。
資料の場所や作業手順が曖昧なら、先に業務棚卸し表で整理します。
そのほうが、試す課題を絞れます。
実演動画では
分からない三つの条件
完成品を見ても、失敗時の扱いまでは分かりません。
一つ目は、どの情報にアクセスしたかです。
社内資料を読む仕事では、モデルの性能以前に、閲覧権限と入力してよい情報の範囲を決めます。
二つ目は、間違えたときに止められるかです。
契約の日付を読み違えた場合、回答をそのまま予定表へ登録する仕組みでは訂正が難しくなります。
最初は回答を下書きにとどめ、人が元資料と照らしてから反映します。
三つ目は、運用を続けられるかです。
担当者が変わっても、同じ資料を探し、出力の根拠を確認できる手順が必要です。
作品の動画は、その場で動いたことを示します。
長く使えるか、誰が直すか、費用が見合うかは、別に確かめる必要があります。
編集部の見方:確認できる
成果で判断する
Opus 5.5の投稿では、コードを書きながら長い作業を進める様子が目を引きます。
細かく分けていた仕事を、まとめて任せやすくなる可能性があります。
「最後まで作れる」と「安心して渡せる」は別です。
画面の動作、コードのテスト、資料の出典は、それぞれ人が確認します。
Xの成功例を、導入の証拠ではなく「試してみたい課題を見つける材料」として使うのがよいと考えます。
業務では、最初からシステム全体を任せません。
元の記録を見れば正誤を判断できる、一つの工程から試してください。
Xのデモは、作れそうなものを考える入口には向いています。
導入判断には、失敗例、修正の手間、結果を確かめる方法も必要です。
大きな仕事を一度で終わらせることだけが、Opus 5.5の価値ではありません。
任せる部分と人が止める場所を決めてこそ、仕事で安心して使えます。
 無料で