Jevを案件管理に使うなら、文章の意味を読む判断だけを任せ、日付の比較・件数・金額の計算はプログラムに戻します。
Jevは、用意した選択肢の中から判断を返すAIです。
返答文は書かず、型の決まった数値と確率を返します。
ただし、英語以外は同じ精度ではないと公式が注意しています。
日本語の過去ログで測るまで、自動処理には使えません。
本記事では、任せる判断の線引き、案件管理の設計例6つ、日本語での測り方を順に説明します。
この記事で分かること
- 人が読んで「これは修正依頼だ」と分かる判断は、Jevに向いています
- 自社の過去ログで、確からしさと正解率の関係を先に測ってください
- 最初は、間違えても並べ直せる「届いた依頼の仕分け」から試します
Jevは文章を書かないAIです
JevはTypeSafe AIが公開した「System One」と呼ばれる種類のモデルです。
文章も、コードも、理由の説明も返しません。
返るのは、はい・いいえの確率、候補から選んだ答え、段階評価の数値です。
チャットに相談する道具ではなく、プログラムの条件分岐に組み込む部品と考えてください。
System Oneという名前は、ダニエル・カーネマンの『ファスト&スロー』の「システム1」が由来です。
公式は、速く直感的な判断を扱うモデルと説明しています。
質問は3種類しかありません
Jevに投げられる質問は3つに限られています。
自由に何でも聞けるわけではなく、答えの形を先にこちらが決めます。
| 質問の型 | 聞けること | 返ってくるもの |
|---|
| Choice(選択) | 用意した選択肢から1つ選ばせる | 選ばれた選択肢/全選択肢それぞれの確率/確からしさ |
| Score(段階評価) | 順序のある段階で評価させる | 確率で重みづけされた数値/各段階の確率/確からしさ |
| Noul(はい・いいえ) | ある条件を満たしているかを聞く | 0から1までの数値(1に近いほど「はい」) |
3種類は1回の通信にまとめて入れられます。
公式は、同じ対象への質問を並列で評価するため、質問を追加しても通常は遅延が増えないと説明しています。
詳細はSpeculative Fan-Outの公式解説で確認できます。
返ってくるのは答えと
確率と確からしさです
たとえば「この問い合わせはどの部署が担当すべきか」をChoiceで聞くと、選ばれた部署名と各選択肢の確率が返ります。
同時に、答えの確からしさを表す0から1の数値も返ります。
1つの選択肢に確率が集中していれば高く、横並びなら低くなります。
ChoiceとScoreには確からしさが付きます。
はい・いいえを聞くNoulには付きません。
Noulで返るのは「はいである確率」です。
ChoiceやScoreの確からしさとは別の数値です。
料金と速度はどれくらいですか?
公式のモデル仕様では、入力100万トークンあたり0.042ドルで、出力トークンは課金されません。
文脈長は1回64,000トークンまでです。
ただし、対象データを入れるstateと最も長い質問の合計は、32,000トークンまでに制限されています。公式仕様の確認日は2026年10月7日です。
公式ブログは応答時間を70〜500ミリ秒と公表しています。
これはTypeSafe AIの公表値であり、本記事ではAPIを実行して測っていません。
入力できるのはテキストだけです。
文字列、JSON、文字列の配列は渡せますが、画像・音声・動画は受け付けません。
請求書のPDFや現場写真を直接投げる使い方はできないので、先に文字へ起こす工程が必要になります。
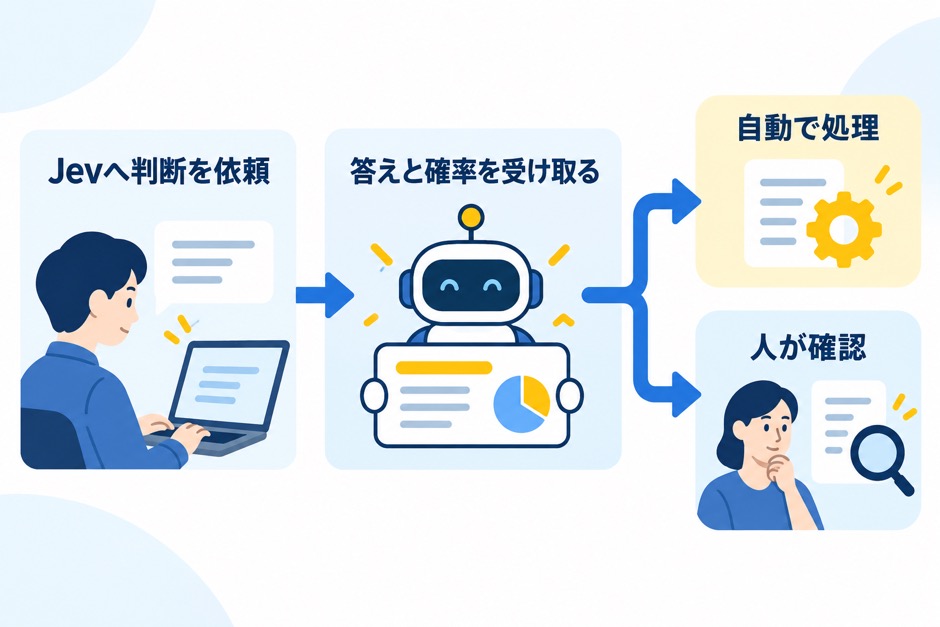 Jevは判断だけを返し、実行と確認の分岐はプログラムが担います。
なぜ案件管理と
相性がいいのでしょうか?
案件管理では、依頼か雑談か、見積の範囲内か、報告文が停滞を示すかといった小さな判断が繰り返し発生します。
Jevの利点は、判断結果を型の決まった数値で受け取れることです。
一般的な生成AIもStructured Outputsやfunction callingで後続処理につなげられますが、Jevはその用途に絞ったモデルです。
案件管理で判断が溜まる場所は
決まっています
複数案件を並行している現場で抜けが出る場所は、おおむね3つに集約されます。
どれも判断が必要ですが、判断そのものは軽い処理です。
依頼がタスクになっていない
チャットやメールに紛れた一文が、誰の手にも渡らないまま流れていきます。
あとから「あの件どうなりましたか」と聞かれて初めて気づく形です。
届いた時点で「これは依頼か」「どの案件の話か」の判定候補を作り、担当者の確認一覧へ残す設計ができます。
追加作業が無償で飲まれている
「ついでにここも直してほしい」が積み重なると、見積の範囲を超えた作業を無償で続けることになります。
1件ずつは小さいため、その場では誰も止めません。
範囲外かどうかを毎回機械で確認すれば、少なくとも気づく機会は作れます。
遅れに気づくのが納期の直前になる
進捗報告に「素材待ちです」と書かれていても、それが何日続いているかは誰も数えていません。
止まっている理由が社外にあるほど、担当者からは声が上がりにくくなります。
任せていい判断と、
任せてはいけない判断
意味を読み取る判定は、自社のデータで試す対象です。数や日付の計算は、通常のプログラムで処理します。
この線引きは、Jev 1.13の公式な失敗モードに基づいています。
計算、日付比較、数え上げ、無関係な情報を多く渡すことなど、9つの苦手な領域が公開されています。
任せていいのは、
文章の意味を読む判断です
人が読んで「これは修正依頼だ」と分かる判断は、Jevに向いています。
依頼文の種類や、条件を満たすかどうかなど、答えの候補を先に用意できる問いに使います。
答えの候補を書き出せない質問は、Jevに投げられません。
たとえば「この案件で次に何をすべきか」は、候補が無限にあるため不向きです。
先に候補を5つまで絞れば、Jevに選ばせられる質問になります。
任せてはいけないのは
計算と数え上げです
公式ドキュメントは「Jevは電卓ではありません」と明言し、計算はコード側で実装するよう強く推奨しています。
案件管理は日付と金額と件数の塊なので、ここを取り違えると事故になります。
日付の比較・計算は任せません
Jevにとって、日付は順序のある量ではありません。文字として読み取ります。
どちらが先か、何日離れているかの計算には向きません。
表記が混ざる場合や、「来週末」のような相対的な言い方が入る場合は、さらに注意が必要です。
文章から日付の要素を取り出すところまではJev、日付の比較と残日数の計算はプログラムが担います。
月や日をChoiceの候補として取り出し、実在する日付かどうかもプログラムで検査します。
数えられません
文章中の語の出現回数や、長いリストの項目数を数える用途も公式が苦手と認めています。
誤差は数える対象が増えるほど大きくなります。
案件管理でいえば「未解決の指摘は何件か」を直接聞いてはいけません。
公式が示す対処は単純です。
候補をプログラム側でループし、1件ずつ「これは未解決か」と聞いて、合計はプログラムが取ります。
質問は並列で評価されるため、20件に分けても通信は1回で済みます。
迷ったときはどう見分けますか?
その判断を人に頼むとき、電卓かカレンダーを渡す必要があるかどうかで分けてください。
渡す必要があるなら、それはプログラムの仕事です。
渡さずに文章を読むだけで答えられるなら、Jevに向いています。
| やりたいこと | Jevに聞く部分 | プログラムが持つ部分 |
|---|
| 納期が危ない案件を洗い出す | 報告文が「止まっている」状態を表しているか | 残日数の計算と、しきい値の判定 |
| 追加見積が必要か判断する | 依頼が契約範囲の外か、新しい成果物が増えるか | 単価表からの金額算出 |
| 指摘の残り件数を把握する | 1件ずつ「未解決か」を判定する | 件数の合計と、報告書への反映 |
| 依頼を案件に紐づける | どの案件の話かを候補から選ぶ | 案件一覧の取得と、タスクの作成 |
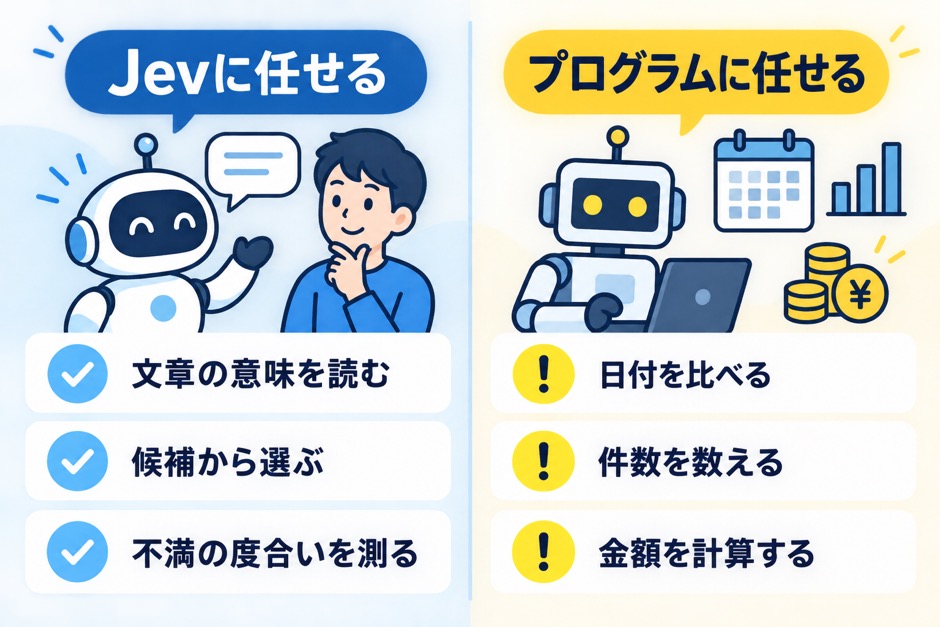 「意味を読む」はJev、「数える・比べる・計算する」はプログラムが担います。
案件管理で任せられる
判断の実例6つ
ここからは、実務での使い方を6つ挙げます。
以下は公式仕様をもとに組んだ未実行の設計例であり、本番利用できることを実測したコードではありません。
コード内の数値は処理の形を説明するための仮値です。
実際に使うときは日本語の過去ログで正解率を測り、各値を置き換えます。
判断対象に渡すのは、質問に必要な情報だけに絞ってください。
関係のない履歴を渡すほど精度が下がると、公式が注意しています。
JSONは公式APIのリクエスト形式に合わせています。
保存したJSONは次の形で送れますが、APIキーと有効なアカウントが必要です。
本記事では送信していません。
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  --data @payload.json
① 届いたメッセージを仕分ける
チャット1通を受け取り、依頼かどうか、どの種類の依頼か、どの案件の話かを一度に判定します。
自動で変わること:案件と依頼の種類が分かると、タスク登録の入力を省けます。
判断に迷いがある場合は登録せず、人へ確認を返します。
実装担当者向け:APIに送るリクエスト例
{
  "model": "jev-1.13.0",
  "state": {
    "message": "先日の件ですが、トップのメインビジュアルをもう1案見せてもらえますか。来週の役員会で出したいです。",
    "known_projects": [
      { "id": "P-102", "name": "コーポレートサイト リニューアル" },
      { "id": "P-118", "name": "採用LP 制作" }
    ]
  },
  "questions": {
    "is_request": {
      "type": "noul",
      "instructions": "message に作業の依頼が含まれているか"
    },
    "request_type": {
      "type": "choice",
      "instructions": "message の依頼の種類",
      "criteria": {
        "new_work": "まだ始まっていない新しい作業の依頼",
        "change": "すでに作った成果物への修正や追加の依頼",
        "question": "作業ではなく確認や質問",
        "info": "依頼ではない連絡や共有"
      }
    },
    "which_project": {
      "type": "choice",
      "instructions": "message が known_projects のどれについてか",
      "criteria": {
        "P-102": "コーポレートサイト リニューアル",
        "P-118": "採用LP 制作",
        "unknown": "特定できない"
      }
    },
    "mentions_date": {
      "type": "noul",
      "instructions": "message に期日や時期への言及があるか"
    }
  }
}
案件の確からしさが自社で決めた基準を下回ったら、タスクを作らず「どちらの案件でしょうか」と1問だけ返します。
期日までの残日数はカレンダーから計算します。
② タスクが着手できる
状態かを検査する
「デザイン修正」とだけ書かれたタスクは、担当が決まっていても着手されません。
何を作れば終わりなのかが書かれていないからです。
そのため、担当を割り当てる前に検査します。
自動で変わること:着手に必要な情報が揃ったタスクだけを担当者へ渡します。
不足があるタスクは、担当者の前で止めて人に確認します。
実装担当者向け:APIに送るリクエスト例
{
  "model": "jev-1.13.0",
  "state": {
    "task": "トップページのメインビジュアルを、役員会用にもう1案作る"
  },
  "questions": {
    "has_deliverable": {
      "type": "noul",
      "instructions": "何を作れば終わりなのか、成果物が特定できるか"
    },
    "has_done_criteria": {
      "type": "noul",
      "instructions": "完了の判断基準が書かれているか"
    },
    "waiting_on_other": {
      "type": "noul",
      "instructions": "着手する前に社外からの情報や素材の提供が必要か"
    },
    "specificity": {
      "type": "score",
      "instructions": "このまま作業を始められるか",
      "criteria": ["このまま始められる", "不明点が1つある", "確認しないと始められない"]
    }
  }
}
自社ログで決めた基準を満たさない場合は、担当者へ割り当てずに差し戻します。
差し戻しの文面はプログラムが持つ定型文にします。
③ 追加見積の見落としを止める
6つの中で、金額にいちばん直結する使い方です。
契約の範囲と今回の依頼を並べて渡し、範囲の外かどうかを判定させます。
自動で変わること:契約範囲の外と思われる依頼を、無償で作業する前に担当者へ通知します。
見積も請求も自動確定しません。
実装担当者向け:APIに送るリクエスト例
{
  "model": "jev-1.13.0",
  "state": {
    "contract_items": [
      "トップページ デザイン1案と修正2回",
      "下層5ページ",
      "CMS組み込み",
      "公開作業"
    ],
    "request": "トップのメインビジュアルを別案でもう2パターンお願いします。あと会社概要に沿革の年表を足したいです。"
  },
  "questions": {
    "in_scope": {
      "type": "noul",
      "instructions": "request の作業が contract_items のいずれかに含まれるか"
    },
    "adds_new_deliverable": {
      "type": "noul",
      "instructions": "request によって契約に無い新しい成果物が増えるか"
    },
    "is_rework": {
      "type": "noul",
      "instructions": "request は納品済みの成果物の作り直しか"
    }
  }
}
自社ログで決めた基準を使い、範囲外と新しい成果物の可能性が高いときだけ、担当者へ通知します。
金額はプログラムが単価表から計算します。
請求の確定は人が行います。
Jevの役割は、追加見積の候補を見落とさないところまでです。
④ 納期より先に詰まりを見つける
進捗報告の文面から、止まっているかどうかと、止まっている理由が社外にあるかを判定します。
自動で変わること:前回から変化がない報告と、社外待ちの報告を担当者の画面で目立たせます。
確信が低い場合は非表示にせず、人の確認リストに入れます。
実装担当者向け:APIに送るリクエスト例
{
  "model": "jev-1.13.0",
  "state": {
    "previous_report": "トップは素材待ちです。下層ページのマークアップに着手しました。",
    "current_report": "先方から素材がまだ届いていないので、トップの実装は待ちです。下層のマークアップは進めています。"
  },
  "questions": {
    "blocked_external": {
      "type": "noul",
      "instructions": "社外からの返答や素材を待って止まっている作業があるか"
    },
    "blocked_decision": {
      "type": "noul",
      "instructions": "決定が下りないことが原因で止まっている作業があるか"
    },
    "progress": {
      "type": "score",
      "instructions": "前回の報告から進んだ量",
      "criteria": ["変化なし", "少し進んだ", "大きく進んだ"]
    }
  }
}
残日数はプログラムが計算します。
日数とJevの判断が自社の基準に達した場合は責任者へ通知し、確からしさが低い場合は人の確認へ回します。
⑤ 受入条件と検査記録を照合する
画面、PDF、コードの実物をJevに検査させる例ではありません。
別のQA工程で作った検査記録に、受入条件を満たす根拠が書かれているかを照合します。
自動で変わること:確認すべき条件の抜けを見つけます。
Jevの判断だけで納品を通さず、最終承認は人が行います。
実装担当者向け:SDKの実行例(API未実行)
from typesafe_sdk import Noul, TypeSafeClient

conditions = [
    "横幅360pxでページ全体の横スクロールが発生しない",
    "問い合わせフォームの送信テストが成功している",
]
inspection_record = """
360pxでscrollWidthとclientWidthは一致。
フォームの送信テストは未実施。
"""

questions = {
    f"cond_{i}": Noul(
        instructions=f"検査記録に、次の条件を満たす根拠があるか: {condition}"
    )
    for i, condition in enumerate(conditions)
}

client = TypeSafeClient(model="jev-1.13.0")
response = client.system_one(state=inspection_record, questions=questions)
scores = [response.answers[f"cond_{i}"].noul for i in range(len(conditions))]
print(scores)  # 自社で測った基準に従って、全件を人が最終確認する
各条件の判定結果を並べるのはPythonであり、モデルに件数を聞いていません。
実物のQAと最終承認を残したまま、確認漏れだけを減らす設計です。
⑥ 今日やる順番を決める
タスクごとに独立した軸で聞き、重みはプログラム側で決めます。
公式のComposite Scoringに沿った組み方です。
自動で変わること:着手できるタスクだけを並べ替えます。
社外待ちや判断待ちは順番を下げず、別の確認リストへ送ります。
実装担当者向け:0〜1に揃える実行例
answers = {
    "client_impact": {"score": 2, "max_index": 2},
    "urgency_expressed": {"score": 1, "max_index": 2},
    "rework_risk": {"noul": 0.7},
    "blocked": {"noul": 0.8},
}

def normalize_score(answer):
    return answer["score"] / answer["max_index"]

if answers["blocked"]["noul"] > 0.5:
    route = "確認リスト"
    priority = None
else:
    route = "今日のタスク"
    priority = (
        0.45 * normalize_score(answers["client_impact"])
        + 0.35 * normalize_score(answers["urgency_expressed"])
        + 0.20 * answers["rework_risk"]["noul"]
    )

print(route, priority)
Scoreの生値とNoulの確率は尺度が違うため、Scoreを0〜1に揃えてから合成します。
係数と停止基準は、自社の過去データで測って置き換えます。
質問の割り方と閾値の決め方
Jevは利用者のデータで追加学習をしません。
公式のModelsページでは、全アカウントに同じ重みを使うと説明しています。
自社に合わせる方法は3つです。
判断に必要な資料を渡す、業務ルールと境界事例を書く、大きな判断を小さな質問に分けます。
機密情報は、保持条件を
確認してから渡します
公式は、顧客のリクエストとレスポンスをモデル学習に使わないと説明しています。
ただし、「学習に使わない」と「保持されない」は別の条件です。
TypeSafe AIのLegalページは、ゼロデータ保持(ZDR)をエンタープライズ向けと説明しています。
契約条項や顧客の連絡先を渡す前に、DPAと保持条件を確認してください。
1つの質問で1つの
ことだけ聞きます
広い質問は、複数の判断を1つの答えの裏に隠します。
1つの質問に入れる判断は、1つだけに絞ってください。
「このタスクは危ないか」と聞く代わりに、着手、担当、完了条件、契約範囲の4問に分けます。
割っても通信回数は増えません。
同じ対象への質問は並列で評価されるので、1回の通信にまとめて入れられます。
割ったほうが、どの判断が外れたのかを後から特定できる分、調整もしやすくなります。
確からしさで3つに分けます
公式のConfidenceガイドは、確からしさの高さで「自動処理」「確認」「人へ回す」の3つに分ける形を示しています。
境目は全社共通の正解ではありません。
間違えたときの影響と、自社ログで測った正解率の両方で決めます。
| 操作の種類 | 間違えたときの影響 | 自動で実行してよい確からしさ |
|---|
| 一覧の並び替え、ラベル付け | 変更履歴があれば元に戻せる | 自社データで誤りを測り、許容できる条件を決める |
| タスクの作成、社内担当への通知 | 誤通知や重複対応につながる | 重複・宛先・誤判定を確認し、自動処理する範囲を限定する |
| 先方への返信、請求の確定 | 対外的な約束や金銭の判断になる | 確からしさが高くても、人の承認を残す |
1つの数値を全部の処理に使い回さないでください。
閾値は操作ごとに別の値を置きます。
使う可能性がある判断も、
まとめて聞きます
一度の通信で、請求のときだけ使う質問と、納期のときだけ使う質問をまとめて送れます。
どの答えを使うかは、プログラムが後から決めます。
公式はこの組み方を「Speculative Fan-Out」と呼んでいます。
確率をログに残します
合否だけでなく、返ってきた確率、確からしさ、判断したモデルIDを保存します。
過去データを使い、別の閾値にした場合の結果を検証できます。
本番運用では、判断を測定した版のIDを固定します。
別の版へ移行するときは、同じ日本語ログで再度測ってください。
日本語で使う前に
何を測ればいいですか?
自社の過去ログで、確からしさと正解率の関係を先に測ってください。
公式の言語サポートには、英語で精度が最も高く、CJKを含む他言語は同等ではないと明記されています。
非英語で使う前に、自分のコンテンツでテストするよう求めています。
なぜ測らずに
入れてはいけないのでしょうか?
精度が分からないまま閾値を置くと、その数字に根拠がありません。
たとえば0.8を自動処理の基準にするなら、日本語のログで0.8以上の判断が実際にどれだけ正しいかを確認する必要があります。
測り方の手順
- 過去ログを集める:案件の種類が偏らないように選びます。件数を先に固定せず、次の手順で分ける各区切りに十分な件数が残るかも確認します。
- 人が正解を付ける:仕分けたい区分で、人の手でラベルを付けます。ここは省けません。
- 同じ質問を投げる:本番で使う予定の質問文と選択肢のまま、まとめて投げます。
- 確からしさごとに正解率を見る:0.5〜0.6、0.6〜0.7のように区切り、それぞれの正解率を出します。
- 閾値を決める:各区切りの件数と誤差も確認し、自動処理してよい範囲を決めます。
この5工程を飛ばして本番に入れると、うまく動いているように見えても理由を説明できません。
AI導入の進め方でも、小さく試して測る段階を飛ばさないことを繰り返し書いています。
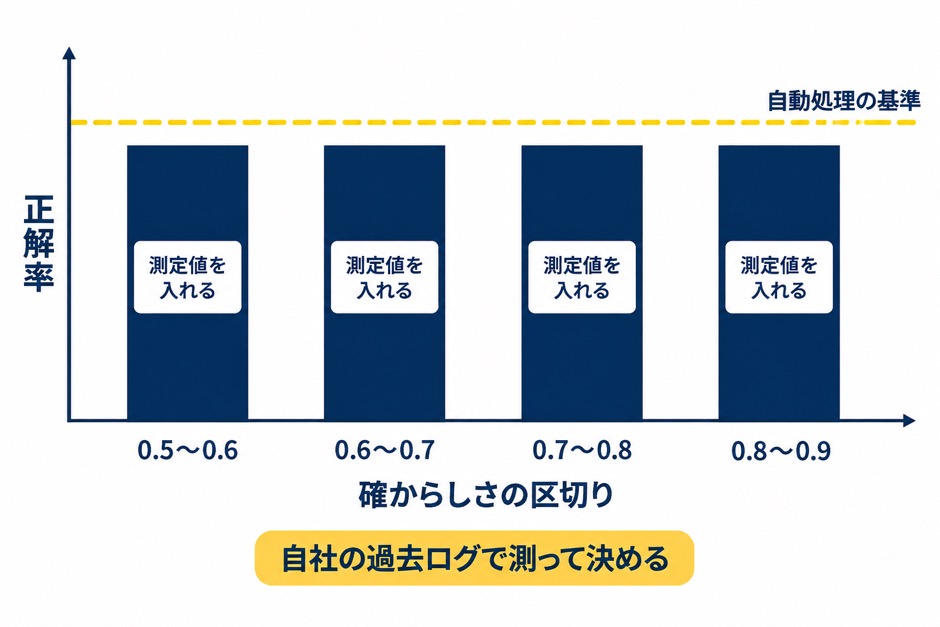 この図に実測値は入っていません。運用先の日本語ログで各区切りの正解率を測ります。
つまずきどころと打ち手
公式が公開している失敗モードのうち、案件管理で実際にぶつかるものを症状の形に直しました。
自分の症状に近い行を探してください。
| 症状 | 起きていること | 打ち手 |
|---|
| 同じような依頼文なのに判定が揺れる | 質問文に複数の判断が混ざっている | 質問を1つずつに割り、組み合わせをコード側で持つ |
| こちらの意図と違う読み方をされる | 書いた言葉どおりに読まれている | 条件を質問文に正確に書き、境目の例を選択肢の説明に入れる |
| 件数や日付の判定が合わない | モデルに計算させている | 抽出だけ任せ、比較と集計はコードでやる |
| 情報を足したのに精度が下がった | 関係のない情報が判断を乱している | 渡す前にコードで絞り、質問に必要な項目だけにする |
| 「至急」と書いた依頼ばかり優先される | 文面の書き方が優先度を動かしている | 優先度の決定はコードの係数と閾値に置く |
| はい・いいえの閾値を選択式に移したら崩れた | 2つの質問型は別の尺度で答えている | 型ごとに閾値を測り直す。流用しない |
公式には、同じ「返金を求めているか」を2つの型で聞いた例が載っています。
Noulは0.22、Choiceは「いいえ」が0.99でした。
片方で調整した閾値を、もう片方へ持ち込まないでください。
どこから始めるか
Jevを案件管理に入れるかどうかは、自社の判断を「候補を書き出せる質問」に割れるかで決まります。
候補を決められない判断は、Jevには任せられません。
最初は、間違えても並べ直せる「届いた依頼の仕分け」から試します。
自動登録はせず、過去ログで正解率を測るところから始めてください。
まるっとAIの相談では、現在のチャットと案件表を見ながら、Jev・一般的な生成AI・通常のプログラムのどれに任せるかを仕分けます。
参考にした公式情報
最終確認日:2026年9月20日。仕様・料金・レート制限は変更される可能性があります。
 無料で