CSVの日本語が違う文字や「?」に見えたら、まず受け取った原本を残し、確認用のコピーで調べます。同じ原本を別の条件で読み直せる場合と、置換後の値しか残っていない場合では、次にすることが違います。 表示を見ただけで文字コードや損失を決め、上書き保存しないことが出発点です。
この記事は、CSVを受け取って集計・登録などへ渡す担当者向けです。読み直す条件を確認するのか、書出元の原データと照合・再依頼するのかを、四つの小さな比較ファイルで説明します。汎用の文字化け修復ツールや、特定製品の移行手順ではありません。
名称、レコード、作成条件、変換履歴と結果はすべて架空の教材です。実顧客データ、Excel等の実画面、外部AIの実行結果ではありません。以下の観察は編集部のオフライン処理で確かめたもので、表計算ソフトを操作した記録とは分けています。
この記事で分かること
- CSV原本を残し、同じバイトの読み直しと書出元への再依頼を分けます
- BOMの有無と読込条件を確かめ、置換後の名称を推測で復元しない判断を示します
- 四つの架空ファイルと確認表で、元データとの照合に不足する根拠を整理します
原本を残し、四つの
比較ファイルの役割を分ける
最初に受け取ったファイルをそのまま保管し、コピーを確認用にします。元ファイル名、入手元、書出日時、選んだ出力形式が分かる記録も残してください。読めない表示をそのまま保存し直すと、調べたかった元の値を比較できなくなる場合があります。
教材の原本Aは、列名がrecord_id,customer、データが1行のCSVです。レコードIDはC01、名称は架空の「山手工房」です。比較用Bは名称だけが「東町企画」という別の可能な原文です。AとBを同じ台帳へ登録する例でも、実在する取引先が改名した例でもありません。
| ファイル |
作成条件と役割 |
ファイルの大きさ |
| source-utf8.csv |
原本A。C01/山手工房をUTF-8で保存 |
38bytes |
| source-utf8-bom.csv |
原本Aの先頭にBOMの3bytesを付けた比較版 |
41bytes |
| alternative-source-utf8.csv |
比較用B。C01/東町企画をUTF-8で保存 |
38bytes |
| lossy-name.csv |
名称だけを置換した出力。C01/???? |
30bytes |
bytesはファイルのバイト数で、文字数とは別です。この教材では列名、ID、カンマと改行も含む保存データ全体を数えています。名称の「山手工房」と「東町企画」はどちらも4文字です。
原本A、BOM付き比較版、別の可能な原文B、名称置換後の出力を配布しています。四つとも選定時に保存したバイトを変えずにコピーしたものです。自分のデータを試す場合も、原本の保管と、確認・変換した別ファイルを分けます。
確認表の空欄CSV、3確認の記入例CSV、手で読む確認メモも使えます。確認表はUTF-8 BOM付きの値だけで、式や自動修復機能はありません。Office・Excel・Sheetsでの実読込は未確認です。コピーへ取り込み、列が分かれたか、IDと名称が元の記録と一致するかを見てください。本文とメモだけでも判断を追えるので、Pythonの実行は不要です。
D01:読込条件が違っても、
原本のバイトは残っている
文字コードは、ファイルのバイト列を文字として読み取るための対応です。D01では、UTF-8で作った原本Aの同じバイト列を、別の読込条件で比べます。
| 同じsource-utf8.csvへの処理 |
この教材で得た名称 |
| CP932を指定して読み取る |
螻ア謇句キ・謌ソ |
| 元のバイト列を、作成時に使ったUTF-8で読み直す |
山手工房 |
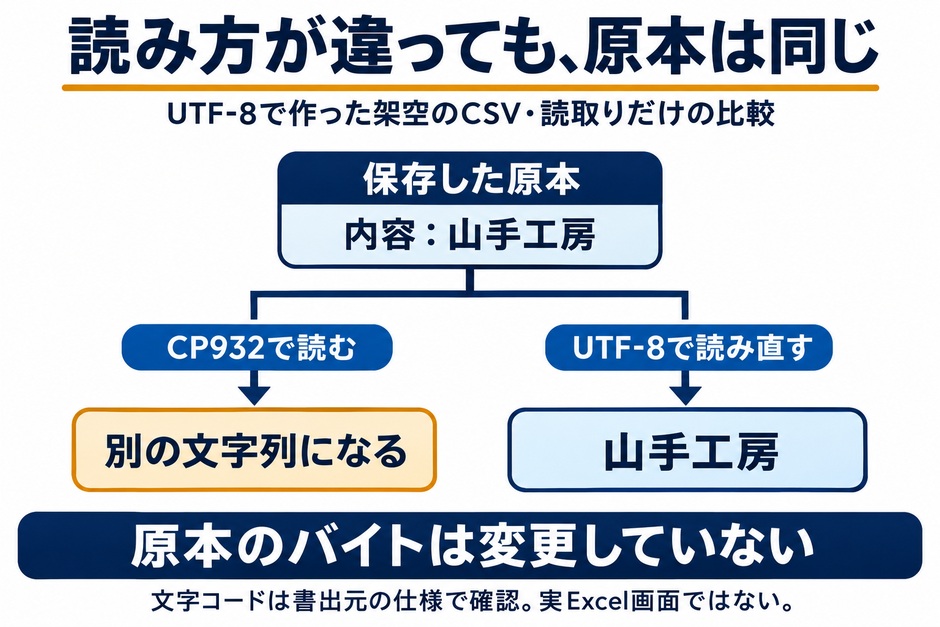 D01:読込条件によって得る文字列が変わっても、保存した原本のバイトは変わらない。
最初の読取りは、エラーがあれば停止するstrictという扱いでもエラーを出しませんでした。それでも、教材で分かっている元の名称とは違います。エラーなく読めたことだけでは、意図した文字コードだとは言えません。 このCP932の一例を、すべてのShift JIS系の実装や製品へ同じ結果で当てはめることもしません。
ここでは読んだ結果を原本へ書き戻していません。原本の38bytesは変わらず残っているため、その同じデータを、既知の作成条件で読み直すと「山手工房」が得られます。「間違って読んだ文字を再保存してから直した」例とは違います。
実際の受領ファイルで頼りにするのは、書出元が指定した形式や、元データとの比較です。読めそうな候補を順に試して、自然な日本語に見えたものを正解と決める方法にはしません。名称がもっともらしくても別の値になっている可能性があるため、該当IDの原データへ戻って照合します。
Pythonのcodecs公式文書にも、外部情報なしでは使用した文字コードを確実に決められないことが説明されています。本稿のプログラムは教材のバイトと結果を確かめるためだけに使い、文字コードの自動特定器や実ファイルの修復機能としては提供していません。
D02:BOMは読込の
手掛かりで、
失われた
名称を戻すものではない
原本Aの先頭へEF BB BFという3bytesを付けたものが、BOM付き比較版です。BOMはここではUTF-8の印として使われています。本文の名称を作り替えたものではありませんが、保存データのバイト列は変わります。
| 比較すること |
この教材の結果 |
| BOMなし原本AとBOM付き比較版のバイト列 |
38bytesと41bytesで異なる |
| BOMを扱うUTF-8の読込(utf-8-sig)後の文字列 |
原本Aと同じ列名・C01・山手工房になる |
| 通常のUTF-8として読む場合 |
見出しの先頭にU+FEFFという文字が残る |
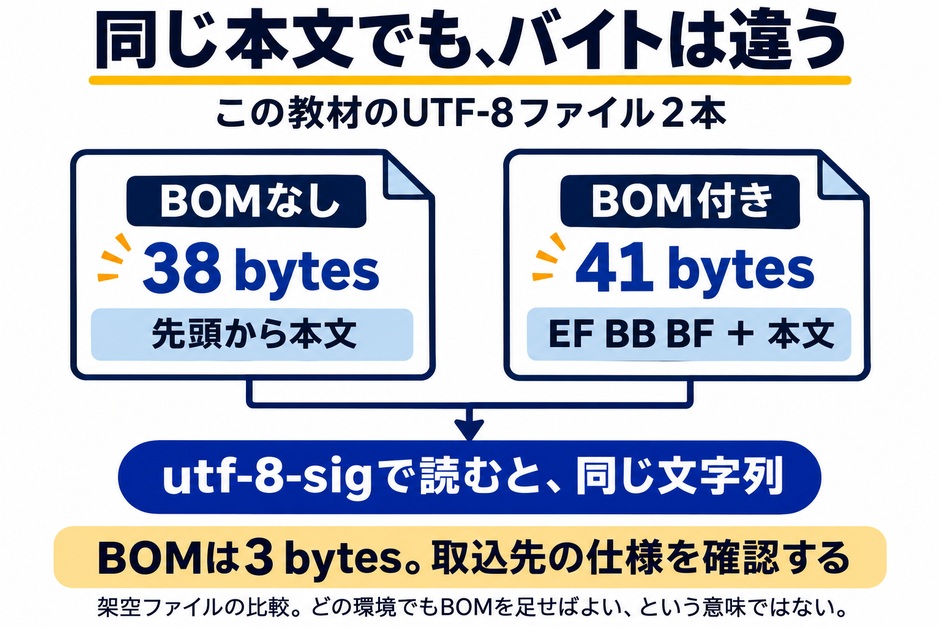 D02:この教材ではBOMの3bytesが増える。utf-8-sigで読むと同じ文字列になるが、取込先の仕様確認が必要。
U+FEFFは見えにくい場合があるため、画面で同じ見出しに見えたことだけで文字列まで同じと決めません。教材の結果では、BOMを扱う読込と、先頭の文字もそのまま読む扱いを分けて確かめています。すべての表計算ソフトで同じ表示になるという実測ではありません。
MicrosoftのUTF-8 CSVの案内は、BOM付きUTF-8の開き方と、それ以外のデータ読込経路を示しています。自分の環境と受け渡し先の仕様を確認するための参照先で、この記事ではExcelの画面操作を試していません。
したがって「BOMを付ければ全CSVが直る」とは考えません。BOMの有無だけで文字コードを確定することも、全提出先へBOM付きの形式を一律に求めることもしません。何を出力し、受け取り側がどう読むかをそろえる話であり、次のD03のように置換された元名称をBOMから取り戻すことはできません。
D03:二つの元名称が、
同じ????へ置き換わる
D03では、名称だけをASCIIで表せない文字の置換へ回し、それ以外の列名、ID、区切りと改行を変えない処理を使いました。PythonではASCIIへの符号化時にreplaceを指定した制御例です。現実のファイルにこの処理があったと推定しているわけではありません。
| 置換前の可能な原文 |
名称だけを置換した結果 |
| 原本A:C01/山手工房 |
C01/???? |
| 比較用B:C01/東町企画 |
C01/???? |
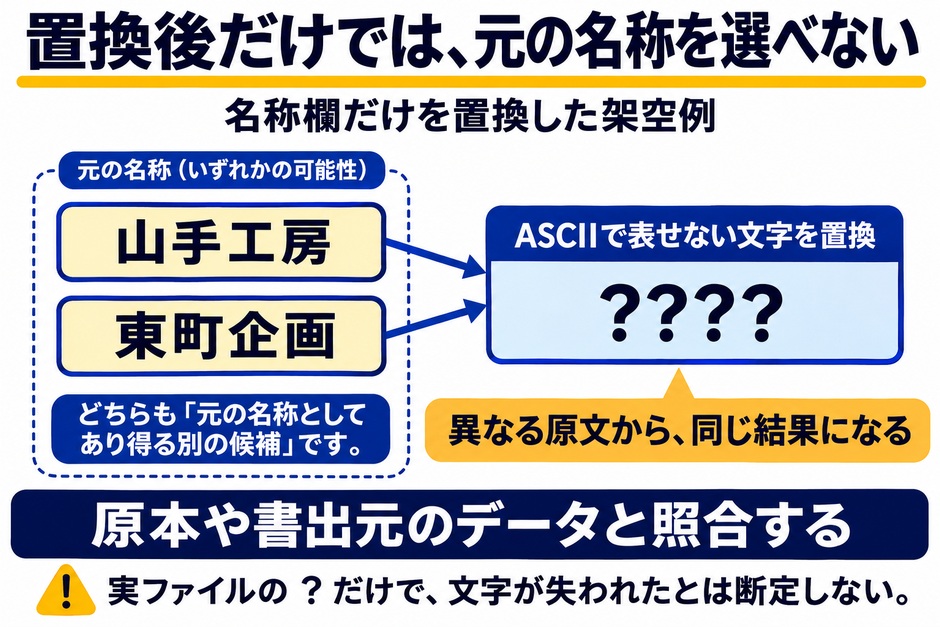 D03:名称欄だけをASCII置換した架空例。置換後だけで元の名称を選べず、実ファイルの疑問符だけから欠損を断定もしない。
名前は違いますが、どちらからも同じ30bytesの出力ができます。そのため、この置換後のファイルだけを受け取っても、元が「山手工房」か「東町企画」かは選べません。 読む文字コードを切り替えるだけでは、出力に残っていない両者の違いを作れないからです。
ここでの「?」は、置換手順が分かっている教材の結果です。実データに「?」や、黒いひし形等に見える置換文字U+FFFDがあっても、見た目だけで同じ損失が起きたと断定しないでください。元から記号が入っていたのか、読込中の表示なのか、変換・保存後の値なのかは、そのファイルと履歴を確かめる必要があります。
また、読み間違えた文字列を別ファイルに保存した場合も、元のバイトがその保存先へ残っているとは限りません。D01の「原本不変」と同じ状態へ勝手にまとめず、どの段階のファイルを持っているか確認します。
原本Aや書出元の原データが残っていれば、そこへ戻って照合できます。比較できる原本がなく置換後の出力しかない場合は、元データ、元の書出ファイル、変換履歴の確認・再依頼が次の仕事です。似た名称やAIの推測で補完し、正しい名称として集計・登録へ渡しません。
実ファイルでは、確認できた
根拠から次の対応を選ぶ
確認表のD01・D02・D03は、作成条件が分かっている教材の記録です。実務では、仕様も履歴も未確認なら、そのまま未確認として書きます。教材の「UTF-8」を自分のファイルへコピーする必要はありません。
| 分かったこと・残る不足 |
次にすること |
| 原本が残り、書出形式を確認できた |
コピーを指定に合う条件で読み込み、元データの値と照合する |
| 読めたが、書出形式や元の値を確認できない |
読み取り成功を確定の根拠にせず、仕様と比較元を確認する |
| 置換・加工した出力で、元ファイルも残っている |
原本と加工後を分け、原本からの再読込・再書出しを確認する |
| 置換後の出力しかなく、元の値を特定できない |
書出元へ原データ・元の書出ファイル・変換履歴を照会する |
読み直した後は、文字が自然に見えるかだけで終えません。この教材なら、C01の名称、列名、2列・データ1行であることを元の記録と照合します。実データでは代表値だけで十分か、どの範囲を確認する必要があるかを、そのデータの用途に合わせて決めます。
列の分割、日付・数値の型、先頭ゼロ、登録先の列仕様は、文字の読み取りとは別の確認です。月次CSVの結合後に値を照合する手順はExcel月次集計の記事へ、元の資料自体がPDFで読取結果を確かめたい場合はPDFからExcelへ移す記事へ進めます。今回の見本がそれらの集計や登録を済ませるものではありません。
書出元へは、対象と
不足する根拠を具体的に聞く
再依頼は「文字化けしたので直してください」だけにせず、どの原本を保管し、どの行をどう確認したいかを添えます。次は実送信していない文面の案です。
共有いただいたCSVの名称欄について確認をお願いします。
受領した原本は変更せず保管しています。
確認したい対象は〔ファイル名・書出日時〕の〔レコードID・列名〕です。

書出時の文字コードとBOMの有無、利用した出力形式を教えていただけますか。
また、該当IDの元データの名称を、共有可能な方法で照合したいです。
途中で変換・置換して保存した場合は、その前の書出ファイルまたは元データから再出力できるかもご確認ください。
元データを丸ごと添付してもらうのではなく、対象と共有可能な範囲を決めます。返信後も、形式が分かったことと元の名称が確かめられたことを別に記録し、解消した確認だけを閉じます。この記事では書出元への連絡や再出力は行っていないため、実際の復旧完了は主張しません。
CSVの文字化けで
迷いやすいこと
 無料で